Делегирование с AI: матрица риска и автономии
Содержание
TL;DR: автономию выбирают для конкретного участка работы: по риску задачи и способности исполнителя заметить, где нужно остановиться. На историях человека и AI-агента разбираю свою рабочую матрицу из четырёх режимов. Для обучающей задачи отдельно определяю, что инженер должен научиться делать сам и как проверить это на следующем случае.
В мае 2026 года AI-агент получил задачу добавить фоновую задачу (scheduler), которая помечала анкеты с истёкшим сроком. Работа шла в отдельной рабочей копии. Агент сам запускал сборку и тесты, читал ошибки, менял код и пробовал снова.
За 16 минут он прошёл примерно 14 циклов. Сначала ошибся в сигнатуре внутренней библиотеки и видимости типов, затем исправлял падения тестов. В конце сборка и тесты стали зелёными.
Готово?
Нет. Scheduler начал запускаться в CI и тестах. Человеку пришлось добавить настройку, которая явно включала фоновую работу только там, где она действительно нужна. Локальный цикл проверил сборку и выбранный набор тестов, но не проверил, в каких средах запускается фоновая задача.
На другом проекте Серёга самостоятельно проектировал журнал складских операций (ledger). Он принёс сильный и технически чистый концепт: прошлое менять нельзя вообще. Никаких документов задним числом, никаких пересчётов старой истории.
Здесь работа остановилась до реализации. Я исследовал, как с прошлыми периодами работают 1С, Saby, МойСклад и Oracle, и пришёл с контраргументом: реальному пользователю нужно вносить запоздавшие документы и исправления. Но бесконечно пересобирать прошлое тоже нельзя. Мы выбрали закрытие периодов, для MVP запретили переоткрытие, согласовали границу, после чего Серёга доработал концепт и реализовал его сам.
В обоих случаях исполнитель мог сделать почти всю работу самостоятельно. Разница была в месте, где самостоятельность должна закончиться.
Делегирование с AI начинается не с вопроса "кто справится?". Сначала нужно решить, где работа обязана остановиться.
Почему таблица "тип задачи × исполнитель" быстро протухает
Удобно написать матрицу: джуну отдать CRUD, мидлу интеграцию, синьору архитектуру, агенту тесты и рефакторинг. Такая таблица выглядит практично, пока не появляется реальная задача.
Грейд человека не показывает, знает ли он этот домен и этот репозиторий. Сильный синьор может впервые увидеть складской учёт и не знать, что закрытие периода меняет смысл поздней операции. Мидл, который два года развивал конкретный модуль, заметит риск раньше него.
С моделями ещё сложнее: их возможности меняются слишком быстро, чтобы поддерживать постоянный список "что уже умеет агент". Способность написать код также не даёт права принимать любое решение. Агент может построить три технически корректных варианта и всё равно не знать, какой ущерб бизнес готов принять.
В первой статье цикла я описывал мидловую работу как "понятное по спецификации". Для разговора о росте людей эта рамка полезна. Для делегирования её недостаточно: одно и то же изменение может быть безопасным в тестовой среде и опасным после запуска на реальных данных.
Поэтому единицей делегирования я считаю пакет работы (work package): ограниченный участок с проверяемым результатом. Исполнителю должно быть понятно, что можно сделать самостоятельно и перед каким действием нужно остановиться. Например, подготовить миграцию и проверить её на копии данных, но не запускать на проде.
Исполнителем может быть человек, один агент или цепочка агентов. Форма контракта от этого почти не меняется.
Что здесь уже известно, а что собрал я
Отдельные механизмы этой статьи давно существуют. OpenAI предлагает оценивать риск инструмента по доступу на чтение и запись, обратимости, необходимым правам и финансовому эффекту. Для чувствительных, необратимых и дорогих действий руководство рекомендует возвращать управление человеку.
Anthropic разделяет сценарии с заранее заданными шагами (workflows) и более самостоятельных агентов (agents). Агент получает факты из среды, останавливается в контрольной точке или когда не может безопасно продолжать, а заранее заданное условие ограничивает число шагов. NIST AI RMF предлагает организациям связывать допустимый риск и возможную цену ошибки с участием человека, явными ролями и ответственностью за решения.
Есть и близкая общая рамка: Intelligent AI Delegation связывает делегирование людям и агентам с характеристиками задачи, полномочиями, доверием и проверкой результата. Авторы отдельно обсуждают нагрузку на контролирующего и риск потери навыков. Это исследовательское предложение, а не доказательство того, что конкретная схема делегирования сработает в моей команде.
Мой вклад здесь прикладной: компактная матрица для выбора следующего участка работы и разбор собственных случаев. Я посмотрел на завершённые задачи через пять характеристик и четыре режима. Auto, Checkpoint, Pair и Human decision ниже – названия моей рабочей модели, а не отраслевой стандарт. Её полезность ещё предстоит проверять на следующих задачах.
Пять вопросов к задаче до выбора исполнителя
Я оцениваю пакет работы по пяти характеристикам. Они не дают математически точного балла. Их задача проще: сделать явными причины, по которым я разрешаю исполнителю идти дальше или останавливаю его.
| Характеристика | Практический вопрос | Что меняется в режиме |
|---|---|---|
| Неоднозначность | Сколько решений нельзя вывести из доступных фактов? | Чем больше неизвестных, тем раньше нужен совместный разбор |
| Цена ошибки | Кто и какие данные пострадают, если результат окажется неверным? | Высокая цена оставляет финальное решение владельцу |
| Обратимость | Можно ли безопасно отменить изменение после применения? | Дешёвый откат разрешает больше автономии |
| Проверяемость | Есть ли независимый способ отличить правильный результат от убедительного отчёта? | Надёжная контрольная проверка позволяет исполнителю дольше работать без человека |
| Учебная ценность | Должен ли человек только выдать результат или ещё приобрести навык? | Обучающая задача может потребовать Pair даже при низком продуктовом риске |
Неоднозначность относится не к объёму кода. Можно изменить 20 файлов по ясному механическому правилу, а можно в одной строке выбрать, разрешены ли операции прошлой датой. Вторая задача короче и сложнее: решение создаёт правило, которого раньше не было.
Цена ошибки, или радиус последствий (blast radius), тоже часто скрыта. Scheduler выглядел локальным: одна фоновая задача, знакомый жизненный цикл, зелёные тесты. Но место его запуска влияло на CI и тестовые среды. Последствия вышли за пределы изменённого файла.
Обратимость нужно оценивать после действия, а не до merge. Ветка легко удаляется. Уже отправленное письмо, утёкший секрет или переписанная история остатков обратно в ветку не складываются.
Проверяемость требует назвать, что именно подтверждает проверка. Тест запроса к данным не отвечает на вопрос, разрешено ли запускать фоновую работу в конкретной среде. Поэтому рядом с результатом проверки я хочу видеть, какой риск она покрывает и что осталось непроверенным.
Учебная ценность появляется только у задач для людей. Если команда хочет вырастить инженера, код становится одним из результатов, а не единственным. Второй результат – способность объяснить модель, защитить компромисс и в следующий раз принять похожее решение без техлида.
Матрица автономии: с чего начать и что потом уточнить
Для первого выбора достаточно двух осей: неоднозначности и цены ошибки.
| Неоднозначность ↓ | Низкая цена ошибки | Высокая цена ошибки |
|---|---|---|
| Низкая неоднозначность | Auto (автономное исполнение): исполнитель делает работу и приносит доказательства | Checkpoint (контрольная точка): исполнение останавливается перед применением или слиянием |
| Высокая неоднозначность | Pair (совместный разбор): дёшево проверяем гипотезы и уточняем модель | Human decision (решение владельца): исполнитель готовит варианты, владелец принимает решение |
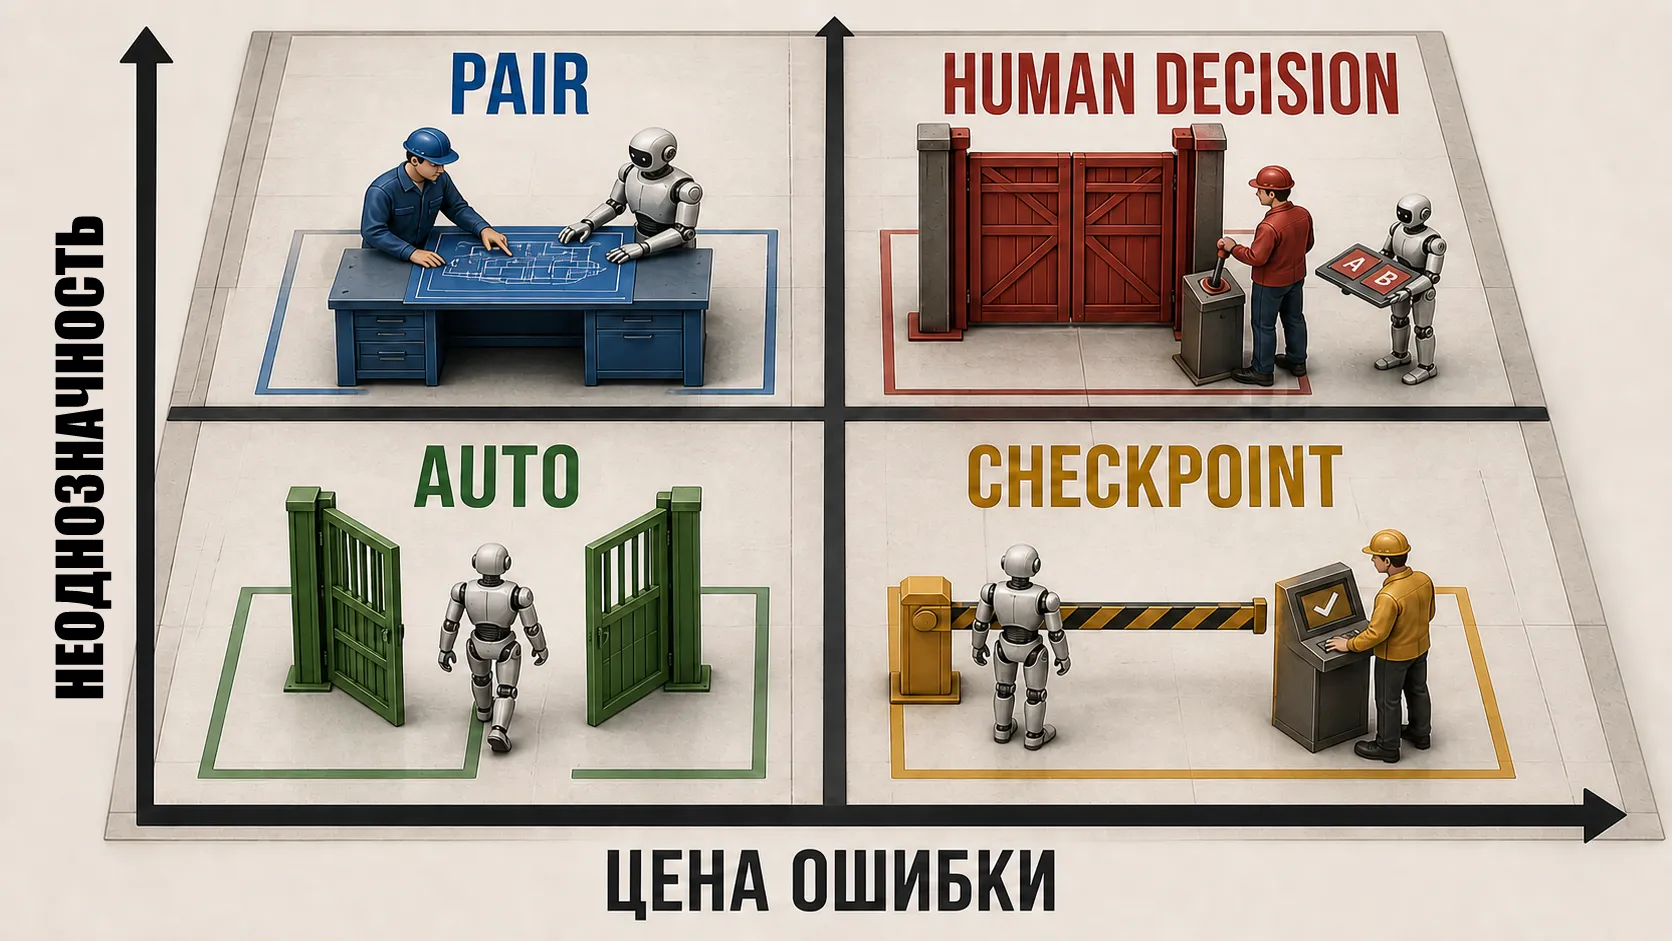
Матрица даёт начальный режим, а не окончательный ответ. Затем нужно учесть обратимость и проверяемость.
Она также не заменяет оценку исполнителя. Человек должен уметь выполнить работу, понять результат проверки и заметить выход за согласованную границу. Доступ к тестам сам по себе этого не гарантирует. Поэтому в одной задаче опытному инженеру можно дать больше самостоятельности, а начинающему предложить совместный разбор. При этом даже полное доверие не разрешает заодно менять правила продукта.
Если ошибку можно отменить одним коммитом, а результат проверяет независимый тест, можно выбрать Auto. Если последствие необратимо, а правильность оценивает тот же исполнитель, который писал код, нужен Checkpoint или Human decision.
Учебная ценность работает отдельно. Безопасный рефакторинг можно полностью отдать агенту, но человеку ту же задачу иногда стоит выполнять в режиме Pair: попросить сначала объяснить модель, затем написать решение и разобрать расхождения. Иначе команда получит код, но не получит нового самостоятельного инженера.
Один Сергей, три разных режима
В начале работы над Pulsell Серёга делал приглашение сотрудников. Задача проходила через три уже выделенные части системы: одна хранила сотрудника и приглашение, другая подтверждала его после регистрации, третья отправляла письмо. Жизненный цикл был понятен, границы между частями уже существовали, а Mailhog и интеграционные тесты позволяли быстро проверить результат.
Серёга сам реализовал задачу. Трудности оставались локальными: подобрать название сервиса и использовать уже принятый инфраструктурный механизм. Ему не приходилось заново решать, что приглашение означает для продукта, поэтому самостоятельность здесь была уместна.
С первыми складскими остатками получилось наоборот. На старте проекта задача звучала примерно так: остатки нужны быстро, сделай простую версию, потом разберёмся. Серёга построил модель на Mongo-документах. Каждый документ хранил текущий остаток конкретной партии товара. Списание меняло или удаляло документ, а отмена пыталась вручную вернуть прежнее состояние. Отдельной неизменяемой записи о самой операции не было.
Первая версия закрыла реальный поток: приёмку, перемещение, списание, оприходование и чтение остатков. Но история операций отдельно не сохранялась. Когда потребовалось помнить происхождение товара, текущий баланс стали использовать и как историю, хотя он не хранил отдельную запись каждого изменения. Документы уже нельзя было удалять, записи с нулевым остатком приходилось сохранять, чтобы не потерять связь с приёмками и оприходованиями, а новые обработчики событий добавляли правила поверх прежних предположений. Даже заявленная транзакционность оказалась неполной: Mongo-сессия создавалась, но BulkWrite выполнялся без неё, поэтому массовое изменение не входило в эту транзакцию.
Я недооценил сложность самой задачи и дал ей режим, похожий на Auto. Она оставалась неоднозначной, цена ошибки была высокой, а будущие сценарии плохо проверялись: до реализации мы не согласовали, как хранить историю и что означает отмена операции. По матрице выбор этих правил требовал Human decision. Ранний Checkpoint должен был остановить реализацию и вернуть нам этот вопрос до того, как предположение превратилось в работающую модель.
Спустя полтора года Сергей сам спроектировал полную модель журнала складских операций. Он предложил запретить документы задним числом и пересчёт прошлой истории. Неизменяемый журнал с добавлением новых фактов (append-only) сам по себе не требует такого запрета: новый факт может относиться к прошлой дате. Спор был о том, какие поздние операции разрешить пользователю и как учитывать их влияние на остатки.
Технически идея сильная. Продуктово – слишком строгая.
Я посмотрел, как знакомые российскому бизнесу системы ограничивают работу с прошлым. В 1С есть дата запрета изменения данных: границу можно задавать по пользователям и разделам, а официальное описание механизма показывает окно в несколько дней после конца месяца. Saby после операций закрытия предлагает зафиксировать счета и документы периода.
В МоемСкладе закрытие периода редактирования документов настраивается по типам документов, а отдельное право позволяет выбранным сотрудникам редактировать закрытые документы. Oracle Cost Accounting прямо описывает операции прошлой датой и статусы учётных периодов.
Ни одна из систем не дала готовый рецепт для Pulsell. Общим было ограничение работы с закрытым учётом: в зависимости от системы поздний документ или исправление требует открытого периода, отдельного права либо контролируемой корректировки.
Мы выбрали компромисс: прошлые операции не переписываем, но поздние исправления проводим через текущий открытый период. В согласованной MVP-модели Pulsell у организации всегда один открытый период. Его можно закрыть, но нельзя переоткрыть в первой версии. Если операция пришла с опозданием, система сохраняет исходную дату документа, а её влияние на остатки учитывает в текущем открытом периоде. Если после закрытия нужно скорректировать фактический остаток, корректировка оформляется новым документом в текущем периоде, а старая запись остаётся неизменной.
После согласования Серёга переработал концепцию и реализовал её самостоятельно.
Если разложить путь от концепта до реализации по участкам, получается такая последовательность:
Checkpoint: Сергей самостоятельно готовит концепт и останавливается перед реализацией, которую потом будет дорого переделывать.Human decision: обсуждаем продуктовую границу; в этой задаче я отвечаю за выбор допустимых правил работы с прошлым.Autoна следующем участке: Сергей самостоятельно дорабатывает модель и код внутри согласованной границы.
Здесь Auto относится не ко всему ledger, а только к реализации после решения о работе с прошлыми периодами. Ответственность за результат осталась у меня, но Сергею уже не требовалось согласовывать каждый следующий технический шаг.
Контрольная точка и решение владельца выполняют разные функции: первая останавливает предыдущий участок, второе определяет, что разрешено дальше. Поэтому они могут следовать друг за другом в одной задаче.
Мне не требовалось ревьюить каждую строку. Моей работой было не пропустить одно решение, которое меняло смысл системы для пользователя.
Почему 14 циклов до зелёных тестов не равны готовому scheduler
В AI-кейсе самостоятельное исправление кода было уместно: у агента были отдельная рабочая копия и быстрая обратная связь. Звать человека после каждой ошибки компиляции не требовалось. Но переход от локально проверенного кода к включённой фоновой работе требовал отдельного условия: "задача выключена по умолчанию вне разрешённых сред".
Как связать задачу, запуск проверок и независимое ревью в воспроизводимый процесс, я разобрал в статье об инженерном harness. Здесь вопрос следующий: до какого действия исполнитель может идти без человека.
После этого похожий пакет работы я бы разделил так:
Auto: написать scheduler, исправлять сборку и тесты, приложить результаты;Checkpoint: показать регистрацию scheduler и конфигурацию сред до merge;Human decision: определить политику включения, если запуск может отправлять сообщения, менять данные или создавать нагрузку.
Режим выбирают заново для следующего участка работы, а не назначают исполнителю навсегда.
Четыре режима без магии
Auto
Исполнитель может закончить работу без промежуточного согласования, если действует внутри явно разрешённой зоны. Для Auto также нужны независимая проверка основного риска и уже готовый безопасный откат, который не требует нового решения. Если способ восстановления выходит за согласованные границы или требует нового выбора, перед ним нужен checkpoint.
Примеры: механическая миграция формата, генерация клиента из стабильного контракта, локальный рефакторинг под существующими тестами. Слово "существующими" здесь опасно: тесты должны проверять нужное поведение, а не просто присутствовать в репозитории.
Checkpoint
Исполнитель работает самостоятельно до заранее указанной точки. Дальше продолжать нельзя, даже если следующий шаг кажется очевидным.
Checkpoint можно поставить перед миграцией данных, изменением публичного контракта, включением фоновой задачи или реализацией архитектурной идеи, которую потом будет дорого переделывать. Его сила в предсказуемости: человеку не нужно круглосуточно наблюдать за работой, а исполнитель не гадает, когда пора позвать владельца.
Pair
Человек и AI или два человека поочерёдно строят гипотезу, проверяют её и уточняют модель. Pair полезен при высокой неоднозначности, когда дешёвые эксперименты постепенно уменьшают неизвестность.
Для обучения у режима есть отдельная функция. Инженер сначала объясняет и обосновывает собственное решение, затем получает контраргументы и уточняет модель. AI может искать варианты и показывать слабые места, но не должен незаметно забрать участок мышления, который команда хотела развить у человека.
Human decision
Исполнитель собирает факты, варианты и последствия. Решение принимает названный владелец.
Этот режим нужен не потому, что человек всегда умнее. Некоторые ответы вообще нельзя получить из кода: допустимый финансовый риск, продуктовая свобода пользователя, юридическое толкование, готовность выпустить неполную функцию. AI может улучшить подготовку решения, но не получает ответственность вместе с красивой таблицей вариантов.
Контракт делегирования на одной странице
Перед запуском задачи я хочу увидеть семь строк.
| Поле | Что написать |
|---|---|
| Результат (outcome) | Какой наблюдаемый результат должен появиться |
| Разрешённая зона | Какие файлы, системы и действия доступны исполнителю |
| Запрещённые действия | Какие действия требуют отдельного разрешения |
| Инварианты | Что результат не имеет права нарушить |
| Доказательства (evidence) | Какие проверки и артефакты подтверждают результат |
| Владелец решения (decision owner) | Кто принимает решение в точке остановки |
| Остановка и откат | При каком факте работа останавливается и как отменяется или компенсируется уже сделанное |
Для ledger результатом был новый источник истины по остаткам. Без отдельного согласования нельзя было решать, как пользователь работает с прошлым. После обсуждения закрепили инвариант: операции закрытого периода не переписываются. До этого запрет на документы задним числом был предложением, которое требовалось обсудить.
Подробный промпт не заменяет этот контракт. Можно на две страницы объяснить агенту стиль кода и забыть назвать действие, после которого он обязан остановиться.
Когда матрица начинает мешать
Семь строк контракта не означают семь обязательных полей в отдельном документе. Для локального переименования достаточно одной фразы в тикете, существующих тестов и обычного ревью. Отдельный контракт нужен, если исполнитель может успеть совершить дорогой или необратимый шаг до проверки владельцем.
Каждая контрольная точка тоже стоит времени. Если ставить checkpoint "на всякий случай", техлид быстро становится диспетчером всех решений, а самостоятельность команды существует только на схеме. В итоге сам процесс контроля становится новым узким местом.
Anthropic описывает, как запрос разрешения на каждое действие привёл к усталости от постоянных согласований (approval fatigue), а жёсткая граница среды позволила реже отвлекать человека внутри безопасной зоны. В моём проекте это не измерялось. Для своей модели я беру отсюда только механизм: в безопасной зоне не нужно запрашивать разрешение на каждый шаг, а перед дорогим действием нужна контрольная точка.
Human decision не означает "принеси мне вообще всё". Владелец нужен только для решения, которое нельзя вывести из доступных фактов или которое меняет допустимый риск. Остальные решения должны оставаться у исполнителя. Иначе матрица автономии превращается в красиво оформленный микроменеджмент.
Узким местом становится способность проверять
Десять агентов могут параллельно написать десять изменений быстрее, чем один техлид их проверит. Если каждый результат требует его решения, очередь на ревью растёт быстрее, а поставка ценности не ускоряется.
В scheduler-кейсе число 16 минут относится только к локальному циклу сборки и тестов. Я не измерял время человеческого разбора, настройки запуска и повторной проверки. Поэтому не могу честно назвать 16 минут временем поставки задачи.
С людьми действует тот же принцип. В этой рабочей модели я считаю делегирование удачным не тогда, когда исполнитель реже задаёт вопросы, а когда результат можно независимо проверить без превращения техлида во второго исполнителя.
Автоматические проверки могут уменьшить объём ручного ревью: контрактные тесты, проверка миграции, сравнение схемы, пробный прогон и контроль запрещённых действий. Решения с высокой ценой ошибки всё равно останутся у человека. Их нельзя бесконечно параллелить, поэтому пропускную способность ревью (review capacity) я предлагаю планировать вместе с количеством исполнителей.
Я бы измерял:
- полное время задачи (lead time) вместе с минутами человеческого ревью;
- переделки и дефекты после применения по классу риска;
- сколько раз исполнитель остановил работу и хватило ли собранных фактов для решения;
- задержку решений и число решений, сходящихся к одному человеку;
- рост самостоятельности инженеров на похожих задачах.
Каждую метрику нужно смотреть рядом с другой. Сокращение lead time при росте переделок может означать, что работа просто быстрее доехала до следующего узкого места. Меньше вопросов от команды может означать зрелость, а может означать, что люди перестали поднимать риски.
Как растить мидлов, если код можно отдать агенту
Серёга описал свой ранний Mongo-вариант жёстко. Но важнее его вывод: пока он читал про Event Sourcing, аудит и ledger в отрыве от проекта, паттерны можно было только принять на веру. Когда текущий баланс начал ломаться от отмен, происхождения товара и новых операций, он увидел, какую конкретную проблему решает каждый механизм.
"Абстрактный клубок в голове, он именно собирается с пониманием что ты делаешь и зачем"
Это свидетельство одного инженера, а не закон обучения. Цена ранней модели была реальной: переделки, усложнение обработчиков и хрупкая история остатков. Специально вести человека к дорогой ошибке ради такого опыта я бы не стал.
В первой статье я оставил вопрос: как вырастет новичок, если агент с первого дня выполняет за него всю задачу? История Сергея не даёт готового ответа. Он пришёл в бэкенд с опытом автоматизации тестирования и уже умел разбираться, как ломаются системы. Вырастить джуна в мидла и помочь опытному инженеру самостоятельно проектировать модуль – разная работа наставника.
Для начинающего я бы выбирал небольшой законченный сценарий в знакомом команде модуле. Например, по аналогии с приглашениями: проследить создание приглашения, его принятие и повторную попытку. Здесь можно разобраться в поведении, изменить код и проверить результат, не проектируя всю систему с нуля. Более опытному человеку можно оставить больше неизвестного: предложить правило отмены и объяснить, какие последствия оно создаёт.
Перед такой задачей я бы договаривался не только о рабочем результате, но и об одном конкретном умении. Например: после неё инженер умеет сам находить, почему повторная операция меняет состояние дважды. Это полезнее цели "разобраться в архитектуре": понятно, что пробовать и что проверять на разборе.
Дальше я предлагаю такой порядок работы.
Сначала человек делает собственную попытку. Если учится отладке, воспроизводит сбой, выдвигает причину и выбирает способ её проверить. Если проектированию – описывает ожидаемое поведение и спорный случай. AI может искать документацию, объяснять незнакомый API или обсуждать гипотезу. Но если сразу поручить ему и найти причину, и исправить код, самостоятельной попытки у инженера не останется.
Наставник помогает там, где человек застрял. Новичку может понадобиться показ отладки с объяснением хода мысли. После этого он сам разбирает соседнюю ветку сценария. Опытному инженеру иногда достаточно контрпримера к его концепту. Одинаковое правило "скажу, что не так, но не скажу как" здесь не подходит: объём помощи зависит от того, что человек уже умеет.
На разборе нужно действие, а не только пересказ. Я бы попросил показать место изменения состояния, воспроизвести ошибку или поменять условие теста и заранее объяснить результат. AI может подготовить убедительное объяснение; способность разобраться с новым условием проверяет уже человека. Если он не понимает конкретный кусок кода, этот небольшой кусок стоит написать или исправить самостоятельно с поддержкой наставника. Запрещать AI во всём проекте ради этого не требуется.
Следующая похожая задача проверяет, что осталось. Например, сначала разобрали две последовательные попытки принять приглашение. Теперь сервер уже принял его, но ответ не дошёл до клиента и тот повторил запрос. Инженеру нужно найти, где повтор может ещё раз изменить состояние, и проверить свою гипотезу. Если он справляется с новым условием с меньшей помощью, на следующем участке ему можно дать больше самостоятельности. Если снова застрял, становится понятно, какую помощь сохранить.
Это предлагаемая практика, не измеренная программа подготовки мидлов. Она требует времени наставника и может замедлить текущую задачу. Поэтому разбор нужно учитывать в плане работы. Смысл затрат проверяется дальше: справляется ли человек с похожим случаем с меньшей помощью. Одно удачное объяснение и несколько закрытых тикетов ещё не основание объявлять рост.
Так в контракте задачи появляются два результата: что изменилось в продукте и что инженер теперь способен сделать сам. У агентской задачи второй цели нет. У человеческой она может быть причиной сохранить совместный разбор даже там, где код уже можно получить автоматически.
Как найти точку остановки за три шага
Сначала называю действие, после которого ошибка станет дорогой или необратимой. Это может быть merge, миграция, отправка письма, включение scheduler или фиксация бизнес-правила.
Затем ставлю перед этой границей самую дешёвую независимую проверку, которая действительно покрывает риск. Если проверки достаточно и откат уже разрешён, пакет может идти в Auto. Если перед действием всё равно нужен человек, получается Checkpoint.
В конце я разделяю то, что можно выяснить, и то, что нужно решить. Неизвестность можно уменьшать дешёвыми пробами в режиме Pair. Когда факты собраны, но выбор всё равно меняет допустимый риск или правило бизнеса, остаётся Human decision с названным владельцем.
Через несколько задач режим нужно пересмотреть. Человек лучше узнаёт домен, команда добавляет проверки, а откат становится дешевле. Пакет, который сегодня требует совместного разбора (Pair), завтра может перейти в автономное исполнение (Auto). Обратное тоже бывает: один инцидент показывает скрытый радиус последствий, и автономию приходится уменьшить.
Я предлагаю эту матрицу как рабочую версию, а не готовый стандарт. Если похожим задачам постоянно нужен другой режим или нагрузка на ревью и число переделок растут, а дорогих ошибок меньше не становится, классификацию нужно менять.
В Telegram-посте о трёх сценариях я поставил на сознательное выращивание инженеров, даже когда агент может сделать ту же работу быстрее. Для меня это начинается с конкретной задачи: человеку оставляют посильный участок для самостоятельной работы, помогают пройти затруднение и на следующем случае проверяют, можно ли расширить его полномочия. Так вопрос первой статьи получает практическое продолжение.
Делегирование с AI – это проектирование режима автономии. Исполнитель меняется, но владелец результата, цена ошибки, доказательства и право остановки должны оставаться явными.
Что почитать
Здесь нет готового рецепта, как заменить AI-агентом джуна или раздать всем больше автономии. Но эти четыре работы хорошо продолжают разговор: что именно должен уметь инженер, когда код может сгенерировать агент, как не принять убедительный ответ за верный и где у делегирования остаётся человеческое решение.
-
Junior Software Developers' Perspectives on Adopting LLMs for Software Engineering – систематический обзор 56 исследований о том, как джуны и студенты используют LLM в разработке. Полезен, чтобы смотреть не только на скорость генерации кода, но и на поиск информации, обучение, ошибки, утечки данных и галлюцинации.
-
What do professional software developers need to know to succeed in an age of Artificial Intelligence? – исследование 21 разработчика, работающего с AI, и карта навыков вокруг его реальных задач. Хорошая точка, чтобы обсудить, чему учить мидла дальше: не только писать промпт, а понимать код, проверять результат и принимать инженерное решение. Это небольшое качественное исследование, поэтому читать его стоит как карту вопросов, а не как готовый стандарт программы развития.
-
Investigating and Designing for Trust in AI-powered Code Generation Tools – работа о том, откуда берётся уместное доверие к помощнику в коде: ожидания, настройка инструмента и проверка его предложений. Хорошо ложится на идею из статьи: зелёный результат ещё не отвечает на каждый важный вопрос.
-
Intelligent AI Delegation – близкая исследовательская рамка для делегирования людям и агентам: она связывает свойства задачи, полномочия, доверие, проверку и риск потери навыков. Моя матрица из статьи из этой работы не следует, но с ней полезно спорить, когда решаете, что оставлять исполнителю, а что – владельцу результата.